同时采集Shopee马来西亚站和Lazada泰国站时,最先暴露的问题通常不是代理连不上。
真正麻烦的是,同一个商品链接换了出口国家后,可能返回不同币种、配送范围和活动信息。有些请求状态码是200,拿到的却是地区提示页;还有些页面标题正常,价格和销量字段却没有完整加载。
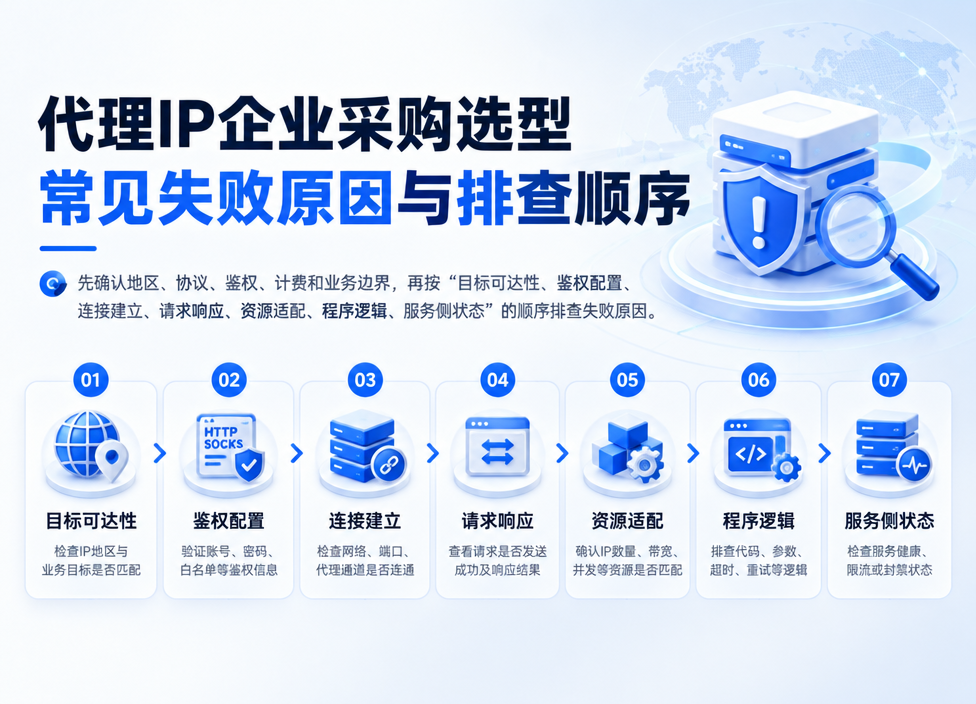
因此,海外HTTP代理只能解决“从哪里访问”的问题。想让采集结果真正进入选品库,还要把代理出口、会话状态、请求节奏和数据校验连成一条完整链路。
为什么代理能连通,采集结果还是不稳定?
因为Shopee和Lazada的数据展示带有明显的地区与会话属性,单纯验证代理连通性远远不够。
例如,一个采集任务要比较马来西亚、泰国和菲律宾三个站点的商品价格。如果所有请求都放进同一个随机代理池,同一批数据里就可能混入不同语言、货币和配送条件。程序虽然抓到了价格,后续分析却无法判断这些价格是否处于同一比较口径。
更稳妥的做法是建立明确绑定关系:
马来西亚站任务 → 马来西亚出口 → MYR货币校验
泰国站任务     → 泰国出口       → THB货币校验
菲律宾站任务   → 菲律宾出口     → PHP货币校验
这种绑定最好贯穿整个任务生命周期,而不是只在请求发出前临时选择一个IP。
同一商品的列表页发现、详情页补全和规格查询,也不适合每请求一次就切换出口。出口频繁变化后,页面语言、活动信息和配送区域可能跟着变化。最终入库的记录看似字段齐全,实际来自几种不同访问条件。
所以,代理轮换应以任务批次为边界,而不是以单次请求为边界。
Shopee和Lazada应该先采集哪些数据?
第一批字段越克制,越容易把链路跑通。
很多项目刚开始就想同时获取商品标题、价格、销量、评论、店铺、规格、优惠、配送和类目排名。字段一多,只要页面有一处变化,整个解析器就可能报错。
跨境选品的第一版数据,建议只保留几类真正影响判断的公开字段:
- 商品ID和商品链接
- 商品标题和类目
- 当前展示价格与币种
- 店铺名称
- 评分与公开评论数
- 展示销量文本
- 发货地区与公开配送信息
- 采集国家、采集时间和代理出口地区
这里有一个容易被忽略的细节:展示值和清洗值要同时保存。
例如页面显示“1.2k sold”,数据库不能只写入数字1200。更稳妥的方式是同时保留:
{
  "sales_text": "1.2k sold",
  "sales_value": 1200,
  "sales_parse_status": "success"
}
价格也一样。原始文本、数值、币种和换算结果应分开存储。否则页面货币识别错误时,错误数据会直接进入分析结果,很难回头定位。
采集表里还需要增加几个技术字段:HTTP状态码、最终跳转地址、响应长度、重试次数和页面类型。它们看起来不属于业务数据,但当大量商品突然缺少价格时,正是这些字段帮助判断问题出在页面变化、地区不匹配,还是请求链路异常。
海外HTTP代理怎样接入采集脚本?
先把单个请求做成可观察、可复查的任务,再考虑并发。
下面以Python的requests为例。代理账号不应直接写入代码,可以从环境变量读取:
import os
import time
import random
import requests

PROXY_HOST = os.getenv("PROXY_HOST")
PROXY_PORT = os.getenv("PROXY_PORT")
PROXY_USER = os.getenv("PROXY_USER")
PROXY_PASS = os.getenv("PROXY_PASS")

proxy_url = (
    f"http://{PROXY_USER}:{PROXY_PASS}"
    f"@{PROXY_HOST}:{PROXY_PORT}"
)

proxies = {
    "http": proxy_url,
    "https": proxy_url,
}

session = requests.Session()
session.headers.update({
    "User-Agent": "Mozilla/5.0",
    "Accept": "text/html,application/xhtml+xml",
    "Accept-Language": "en-US,en;q=0.8",
})

def fetch_page(url):
    time.sleep(random.uniform(2, 5))

    response = session.get(
        url,
        proxies=proxies,
        timeout=20,
        allow_redirects=True,
    )

    return {
        "request_url": url,
        "final_url": response.url,
        "status_code": response.status_code,
        "content_type": response.headers.get("Content-Type", ""),
        "content_length": len(response.content),
        "html": response.text if response.status_code == 200 else None,
    }
这段代码不复杂,但比“请求成功后直接解析HTML”多保存了三个重要信息:最终地址、内容类型和响应长度。
如果多个不同商品返回了长度接近、结构完全相同的页面,就要怀疑拿到的是统一提示页,而不是正常商品详情。状态码200只能说明服务器返回了内容,不能证明内容就是目标数据。
还要注意,HTTP代理可以用于访问HTTPS页面,前提是代理服务支持HTTPS隧道。这里的“HTTP代理”描述的是代理接入方式,不代表只能请求HTTP链接。
列表页和详情页为什么要分开采集?
列表页适合发现商品,详情页适合补全字段,混在一个任务里会让失败成本变高。
以跨境选品为例,列表页通常承担两个任务:找到商品链接,以及记录商品当时在列表中的位置。此时只需要保存商品ID、链接、展示价和发现时间,不必立即解析全部详情。
第一阶段可以形成一张发现表:
{
  "site": "target_marketplace",
  "country": "MY",
  "product_id": "123456",
  "product_url": "https://example.com/item/123456",
  "list_price_text": "RM 29.90",
  "rank": 18,
  "discovered_at": "2026-09-28T10:30:00+08:00"
}
第二阶段再由详情队列补充标题、规格、店铺、评分和配送信息。
这样做有两个好处。
第一,详情页暂时失败时,列表发现结果不会丢失。任务恢复后,可以继续按商品ID补全。
第二,列表页和详情页可以使用不同的速度。列表发现需要翻页,但字段少;详情页内容复杂,更适合降低并发,并设置单独的重试队列。
对于Shopee和Lazada这类页面结构可能调整的平台,这种拆分也能缩小维护范围。详情字段发生变化时,只需要暂停详情解析器,不必让整个发现任务一起停掉。
代理轮换、限速和重试怎么配合?
轮换解决的是出口故障,限速解决的是任务节奏,两者不能互相替代。
比较实用的策略是:一个国家站点对应一个代理池,一个工作进程维持一个会话,完成一定数量的商品后再释放。只有连接失败、代理鉴权异常或出口不可用时,才切换节点。
遇到不同错误,也应采用不同动作:
| 现象 | 更合适的处理 |
|---|---|
| 连接超时 | 更换节点后有限重试 |
| 代理鉴权失败 | 检查账号、白名单和授权状态 |
| 返回429 | 暂停任务,降低并发并延长间隔 |
| 返回403 | 检查页面权限、地区和请求条件 |
| 返回空页面 | 判断是否为脚本加载或地区提示页 |
| 多个商品返回相同内容 | 检查是否获取了统一提示页面 |
重试次数不宜无限增加。对于跨境选品任务,单条记录重试两到三次通常已足够判断问题是否具有持续性。持续失败的任务应进入复查队列,而不是在主队列里循环。
请求间隔也不必固定成完全相同的数值。可以在合理范围内加入随机等待,并按国家站点分别设置并发。第一次上线时,先从单进程和低并发开始,观察成功率、响应时间和字段完整率,再逐步放大。
如果页面中的商品数据依赖脚本加载,单纯请求HTML可能拿不到完整内容。此时应先确认公开字段的实际加载方式,再决定使用浏览器渲染还是平台提供的开放接口。不要在没有确认数据来源前,盲目增加代理数量。
数据入库前怎样判断能不能用?
至少要通过地区、主键和字段完整性三层校验。
地区校验最直观。马来西亚站采集结果应检查页面币种、语言或配送地区是否符合预期。如果代理显示位于马来西亚,页面却持续返回其他地区内容,就不能只相信代理出口标签。
主键校验用于防止跳转。任务请求的是商品A,最终页面中的商品ID必须仍然是A。否则,即便标题和价格都存在,也不能直接写入。
字段完整性则需要根据业务设置最低标准。用于跨境选品时,商品ID、标题、价格、币种、站点国家和采集时间通常应设为必填。缺少其中任何一个,记录都应进入复查表。
还可以给每条记录计算一个简单质量分:
def quality_score(item):
    required_fields = [
        "product_id",
        "title",
        "price",
        "currency",
        "country",
        "collected_at",
    ]

    valid_count = sum(
        item.get(field) not in (None, "")
        for field in required_fields
    )

    return valid_count / len(required_fields)
质量分的意义不是替代人工判断,而是避免明显不完整的数据直接进入正式分析。
价格变化也要做幅度检查。如果某商品上一批次还是正常区间,下一次突然变化数倍,应先复查币种、规格和活动状态。跨站点采集里,币种错误经常比页面解析失败更难发现,因为数据格式看起来完全正常。
FAQ
Q:采集Shopee和Lazada时,需要每次请求都更换IP吗?
不需要。同一国家、同一批次和同一商品链路更适合保持稳定会话。只有节点连接失败、代理不可用或任务批次结束时,才需要按规则切换。
Q:为什么代理显示在目标国家,页面货币还是不对?
代理出口只是影响页面展示的一个条件。站点选择、链接地区、Cookie、语言设置和配送区域也可能影响结果,因此必须同时校验页面货币、最终地址和站点信息。
Q:状态码200是否代表商品采集成功?
不代表。返回内容可能是地区提示页、空模板或其他通用页面。还需要检查商品ID、页面标题、响应长度和必填字段,确认内容与目标商品一致。
Q:遇到429后能不能直接切换代理继续采集?
不建议只更换代理。429首先说明当前任务节奏需要调整,应暂停对应队列、降低并发并增加等待时间,否则相同问题可能在其他出口继续出现。
Q:列表页与详情页必须拆开吗?
小规模测试可以放在一起,但任务量扩大后建议拆分。这样能分别控制速度、记录失败,并在详情解析异常时保留已经发现的商品链接。
Q:什么时候需要使用浏览器渲染?
当公开字段没有出现在初始HTML中,而是在页面脚本运行后加载时,可以评估浏览器渲染。使用前应先确认字段来源和平台规则,避免把链路复杂化。